Memilih Model Open-Weight untuk Ekstraksi Dokumen Berbahasa Indonesia
Cara memilih model open-weight untuk ekstraksi KTP, slip gaji dan rekening koran berbahasa Indonesia: lima hal yang diuji dulu, data tetap di Indonesia.
Model open-weight untuk ekstraksi dokumen berbahasa Indonesia sebaiknya dipilih dari hasil uji pada sampel dokumen klien sendiri, bukan dari peringkat benchmark umum. Ada lima hal yang perlu dicek lebih dulu: cakupan bahasa, jenis dokumen, output terstruktur, kebutuhan GPU, dan lisensi.
Catatan desain ini adalah pola yang bisa dibangun di IONext, bukan laporan proyek tertentu. Arsitektur lengkapnya, dari penyimpanan sampai observabilitas, ada di artikel Document AI dan OCR untuk dokumen nasabah tanpa data keluar Indonesia.
Apa yang perlu dicek sebelum memilih model?
Cek lima hal ini sebelum menjalankan uji akurasi: apakah model mengenal bahasa Indonesia, apakah cocok dengan tata letak dokumennya, apakah bisa mengikuti skema JSON, muat di GPU mana, dan apakah lisensinya boleh dipakai di proyek komersial. Model yang gagal di salah satu poin ini tidak perlu diuji lebih jauh.
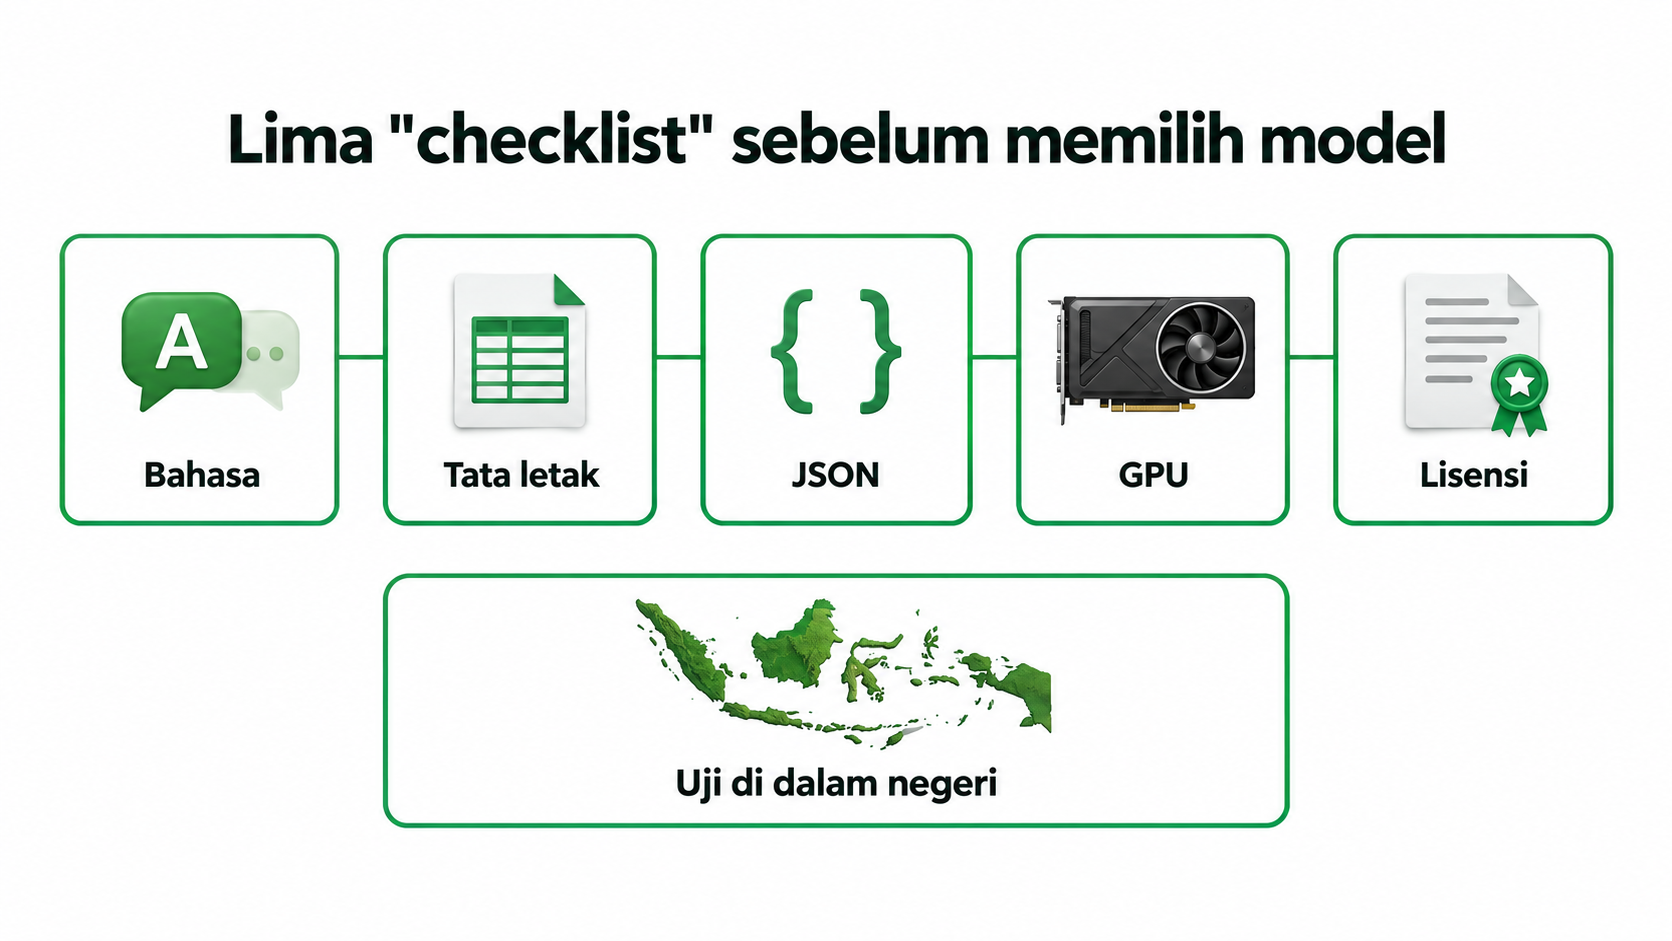
| Pertanyaan | Kenapa penting | Cara mengecek (per Oktober 2026) |
|---|---|---|
| Apakah bahasa Indonesia dan aksara Latin didukung? | Model yang dilatih terutama untuk bahasa Inggris sering salah membaca singkatan, nama dan format alamat lokal | Baca model card. Contoh: Granite-Docling menyebut fokus utamanya bahasa Inggris, sementara PaddleOCR-VL menyebut dukungan 109 bahasa |
| Dokumennya bertata letak tetap atau berisi tabel panjang? | KTP dan NPWP cocok untuk OCR lalu LLM teks. Rekening koran butuh analisis tabel atau vision-language model | Uji terpisah per jenis dokumen, jangan dicampur |
| Bisakah model mengikuti skema JSON? | Field yang tidak terbaca harus bernilai null, bukan tebakan |
Pastikan server inference mendukung structured output atau JSON schema |
| Muat di GPU mana? | Model OCR kecil bisa berbagi satu GPU dengan komponen lain. Model kelas 27B butuh ruang VRAM jauh lebih besar | Ukur pemakaian memori dengan panjang dokumen dan ukuran batch yang nyata |
| Boleh dipakai komersial? | Proyek SI untuk klien adalah pemakaian komersial | Baca file lisensi tiap model. PaddleOCR-VL dan Granite-Docling memakai Apache-2.0 |
Bagaimana mengujinya tanpa membuat proyek kecil jadi riset panjang?
Siapkan beberapa puluh dokumen per jenis, isi kunci jawabannya secara manual, lalu bandingkan dua atau tiga kandidat dengan metrik yang sama. Selain akurasi per field, hitung berapa kali model mengisi field yang sebenarnya tidak terbaca. Untuk dokumen nasabah, angka itu lebih penting daripada akurasi rata-rata.
Jalankan pengujian di infrastruktur dalam negeri. Sampel uji yang belum dianonimkan penuh tetap data pribadi, dan rekening koran serta slip gaji termasuk data keuangan pribadi menurut UU PDP.
Di mana IONext berperan
IONext menyediakan dua jalur untuk pola ini, keduanya di Jakarta. Pertama, managed inference melalui API yang kompatibel dengan OpenAI. Per 12 Oktober 2026 katalognya memuat Qwen3.8-27B, yang menerima input gambar dan mendukung structured output. Kedua, VM GPU NVIDIA L40S 48GB dan NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB untuk men-host model OCR sendiri seperti PaddleOCR-VL, dikelola lewat ORBIT dan dipantau dengan IONA.
IONext tidak memilihkan model untuk proyek klien dan tidak menerbitkan angka akurasi. Hasil evaluasi tetap milik tim SI dan klien.
Untuk mencoba ORBIT dan IONA, buat akun di console IONext. SI yang sedang menyiapkan proposal Document AI bisa berdiskusi lewat Program Mitra IONext.
Sumber
- PaddleOCR-VL, model card di Hugging Face
- Granite-Docling-258M, model card di Hugging Face
- IONext llms.txt, katalog model managed inference
- UU No. 27 Tahun 2022 tentang Pelindungan Data Pribadi, Pasal.id
- IONext Signals: Document AI dan OCR untuk dokumen nasabah
Artikel ini adalah informasi umum, bukan nasihat hukum. Konsultasikan penerapan UU PDP, PP 33/2026 dan POJK dengan penasihat hukum Anda.
IONext adalah infrastruktur AI berdaulat yang di-host di Indonesia, dioperasikan oleh PT Data Awan Nusantara di Jakarta. IONext menyediakan GPU as a Service, managed inference melalui API yang kompatibel dengan OpenAI, dan hosting model open-weight, bersertifikat ISO/IEC 27001:2022 oleh TÜV NORD.